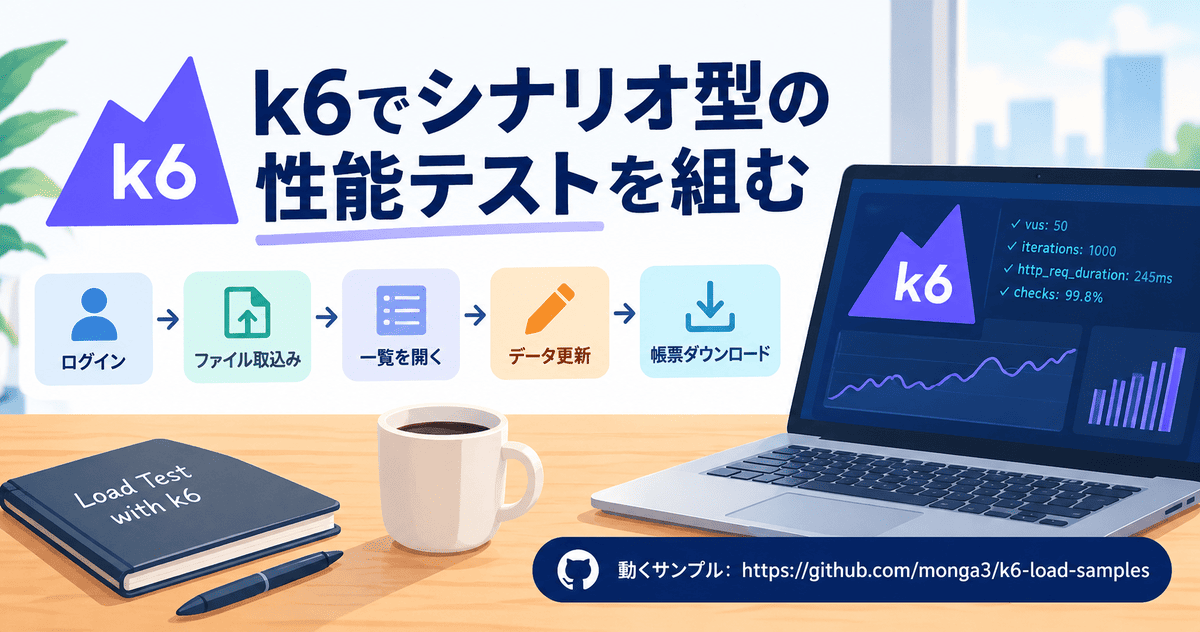
業務システムの性能試験では、単発のAPIを叩くだけでは足りないことがよくあります。ログインして、ファイルを取り込み、一覧を開き、データを更新し、帳票をダウンロードする。この一連の操作を再現して初めて、本番に近い負荷になります。
k6でこうしたシナリオを組むときの構成を、動くサンプル(monga3/k6-load-samples)とあわせてまとめます。想定読者は、性能試験の経験はあるもののk6は初めてという方です。k6固有の用語は登場した順に説明します。
本記事は k6 v1.x を前提にしています(動作確認は v1.7.1)。
1. このサンプルがすること
1人のユーザーが業務システムで一連の操作を行う流れを、1つのシナリオとして実装しています。
| # | ステップ | やること |
|---|---|---|
| ① | ログイン | 認証してトークンを取得 |
| ② | ファイルアップロード | CSVをmultipartで送信 |
| ③ | データ取得 | 一覧を2本取得 |
| ④ | データ更新 | 登録 → 更新 → 読み直して反映を確認 → 削除(既定の接続先では登録まで) |
| ⑤ | ダウンロード | 指定サイズのファイルを取得し、バイト数を確認 |
このシナリオを複数のVU(仮想ユーザー)で同時に実行し、ステップごとの応答時間と成否を記録します。
1-1. 実行
k6をインストールしてリポジトリを取得すれば、そのまま動きます。負荷をかける先にはGrafanaが公開しているデモAPIを使うので、テスト対象のサーバを自分で用意する必要はありません。
git clone https://github.com/monga3/k6-load-samples.git
cd k6-load-samples

k6 run scenarios/smoke.js   # 疎通確認(1VU × 1回だけ)
k6 run scenarios/load.js    # 負荷試験(既定は 5VU・45秒)
レポートは reports/ に出ます。出力先は実行時のカレントディレクトリ基準で解決されるので、リポジトリのルートで実行してください。
k6はパッケージマネージャ(brew / apt / choco)でインストールすると最新版が入ります。本記事の v1.x に揃えたい場合は GitHub Releases からバイナリを取得します。インストーラは不要で、展開して出てくる実行ファイル1つで動くため、既存のk6と共存できます。
# 例: Linux (amd64)
curl -sL https://github.com/grafana/k6/releases/download/v1.7.1/k6-v1.7.1-linux-amd64.tar.gz | tar xz
./k6-v1.7.1-linux-amd64/k6 version   # k6 v1.7.1 ... と出れば成功
macOSは k6-v1.7.1-macos-arm64.zip(Intelなら -amd64)、Windowsは k6-v1.7.1-windows-amd64.zip を展開します。
実行すると、次のようなサマリが表示されます。
  k6 サンプル負荷テスト
  環境: public  接続先: https://quickpizza.grafana.com
  実行時間: 48.6s  リクエスト: 231  エラー率: 0.00%  check成功率: 100.00%

  ステップ別 応答時間(成功したリクエストのみ)
    step              success        avg      p(95)        max
    step_login        100.00%   232.5 ms   299.5 ms   316.3 ms
    step_upload       100.00%   527.5 ms   573.0 ms   580.7 ms
    step_fetch        100.00%   382.0 ms   391.1 ms   400.5 ms
    step_update       100.00%   465.5 ms   514.7 ms   517.2 ms
    step_download     100.00%   393.4 ms   733.5 ms   753.4 ms

  しきい値
    ✓ step_fetch               p(95)<2000
    ✓ step_update              p(95)<3000
    ✓ step_download            p(95)<5000
    ✓ http_req_failed          rate<0.01
    ✓ step_upload              p(95)<3000
    ✓ checks{group:::04_update} rate>0.99
    ✓ step_login               p(95)<2000
    ✓ group_duration{group:::04_update} p(95)<3000
    ✓ checks                   rate>0.99

  結果: すべてのしきい値を満たしました
  レポート: reports/20260905_154915_report.html
同時にHTMLレポートも生成されます。以降は、この結果を出すまでに何をどう組んだかを順に説明します。
1-2. 負荷をかける先
接続先にはGrafanaが公開している QuickPizza を利用しています。5ステップぶんのエンドポイントがこれ1つで揃うので、テスト対象を自前で用意しなくてもシナリオ全体を通しで動かせます。
ただし共有環境なので、VUを増やして本格的に負荷をかけるのには向きません。また、公開デモの default ユーザーは更新・削除(PATCH / DELETE)が許可されていないため、④の更新ステップは登録までにしています(create-only)。更新・削除まで通したい場合は、QuickPizzaをローカルで起動し、default 以外のアカウントを data/accounts.json に用意したうえで、--env API_BASE_URL=... で接続先を差し替え、--env UPDATE_VERIFY_MODE=patch を付けます。
公開デモ環境の制約については、リポジトリのREADMEにまとめています。
2. k6の基本
2-1. VU と iteration
k6の負荷は VU と iteration という2つの単位で決まります。
- VU(Virtual User) は並行して動く実行単位です。同時に何人が操作しているかに相当します。
- iteration(反復) は
export default function () { ... }を1回実行することです。シナリオを最初から最後まで1周するイメージです。
各VUは default 関数を最後まで実行すると、また先頭へ戻って同じ処理を繰り返します。10VUで実行すれば、10人のユーザーが同じ操作を繰り返している状態になります。
ただし、VU数がそのままスループットになるわけではありません。
スループット(iteration/秒) ≒ VU数 ÷ 1 iterationの所要時間1 iterationに2秒かかるなら、10VUでも毎秒5 iterationしか出ません。サーバの応答が遅くなればiterationも長くなるので、スループットはその分だけ下がります。つまり、VU数を固定する試験で再現できるのは同時実行数であって、リクエスト量ではありません。
「毎秒100件流したい」のように流量を決めたい場合は、VU数ではなく**単位時間あたりに何回iterationを開始するか(到着率)**を指定します。
こうした「どうやって負荷をかけるか」の指定方法を、k6では executor と呼びます。全部で7種類ありますが、指定する軸は「VU数」か「到着率」の2つです。VU数を指定すればスループットは結果として決まり、到着率を指定すればそれを満たすようにk6がVU数を調整します。
| 指定するもの | executor | 動き |
|---|---|---|
| VU数 | constant-vus | 一定に保つ |
| VU数 | ramping-vus | 段階的に増減させる |
| VU数 | per-vu-iterations | 1VUあたりN回実行したら終わる |
| VU数 | shared-iterations | 合計N回を全VUで分担したら終わる |
| 到着率 | constant-arrival-rate | 一定に保つ |
| 到着率 | ramping-arrival-rate | 段階的に増減させる |
画面操作のように「何人が同時に使っているか」を再現したいならVU数、バッチ処理やAPI連携のように「毎秒何件流すか」が重要なら到着率を指定します。このサンプルは人が画面を操作するシナリオを想定しているため ramping-vus を使っています。
表に載っていない7種類目の externally-controlled は、実行中のテストを外部APIから制御するためのもので、負荷モデルをあらかじめ決めておく通常の性能試験では出番がありません。
VU数を指定する試験では、sleep() をどこに入れるかもセットで考えます。待ち時間を入れないと、レスポンスを受け取った瞬間に次のリクエストを送り続けることになり、同じ10VUでも人が操作する場合よりかなり強い負荷になります。
sleep(randomBetween(0.5, 1.5)); // 次の操作まで 0.5〜1.5 秒待つ2-2. init コンテキストと VU コンテキスト
initコンテキストではファイルを読めますがHTTPリクエストは投げられず、VUコンテキストはその逆になります。
// init コンテキスト:テスト起動時に1回だけ実行される
// ファイル読み込み、設定パース、メトリクス定義はここに書く
const accounts = new SharedArray("accounts", () =>
  JSON.parse(open("./accounts.json")).accounts
);

export const options = { /* ... */ };

// VU コンテキスト:VUごと・iterationごとに何度も実行される
export default function () {
  // HTTPリクエストはここで実行する
}
ファイルを読む open() はinitコンテキストでしか呼べません。一見不便ですが、この制約のおかげでテストデータの読み込みがVUの数だけ繰り返される事態を防げます。
読み込んだ配列は SharedArray に入れます。名前のとおり全VUで1つの配列を共有するためのクラスで、第1引数は識別用のラベルです(エラーメッセージにも表示されます)。10MBのJSONを100VUがそれぞれ保持すると単純計算で約1GBになりますが、SharedArray なら10MBのままで済みます。
2-3. options に実行条件をまとめる
options は、テストをどのように実行するかを定義するオブジェクトです。VU数、実行時間、合格条件といった設定はここへまとめ、スクリプトから export const options として公開します。
Options configure test-run behavior. For example, options are how you define test tags, thresholds, user agents, and the number of virtual users and iterations.
— Options
export const options = {
  // どんな負荷をかけるか
  scenarios: {
    load: {
      executor: "ramping-vus",
      stages: [{ duration: "30s", target: 10 }]
    }
  },
  // 何を満たせば合格か
  thresholds: {
    http_req_failed: ["rate<0.01"],
    checks: ["rate>0.99"]
  },
  summaryTrendStats: ["avg", "min", "med", "p(90)", "p(95)", "max"]
};
scenarios を書かず vus と iterations だけを指定する短い書き方もあります。この場合k6は内部で default という名前のscenarioへ展開します({"default":{"executor":"shared-iterations","vus":1,"iterations":1,...}} のようになります)。最初は vus / iterations から入り、負荷カーブを作り込む段階で scenarios へ移行する、という順で問題ありません。
options を書ける場所はスクリプトだけではありません。 設定ファイル、環境変数、CLIフラグからも渡せて、同じ項目が複数から指定されたときの優先順位が決まっています。
デフォルト値
  < 設定ファイル(--config)
  < スクリプトの options
  < 環境変数
  < CLIフラグ
そのため「スクリプトだけ読めば実行条件が分かる」とは限りません。実際に確定した値は exec.test.options で参照できます。
値が確定するのは起動時です。k6はテスト開始前にoptionsを解釈してVUの起動計画を立てるので、VUコードから options を書き換えても実行中の挙動は変わりません。
2-4. VUと反復に振られる番号
k6は、起動したVUと実行した反復のそれぞれに通し番号を振っています。「1人目のVUには1番目のアカウントを使わせる」ならVU番号、「1反復ごとに別のレコードを使わせる」なら反復番号を使います。どちらも k6/execution から取得できます。
| 取得方法 | 意味 |
|---|---|
exec.vu.idInTest | VU番号(テスト全体で一意・1始まり) |
exec.scenario.iterationInTest | 反復番号。そのscenarioの通し番号(0始まり) |
exec.instance.vusActive | 現在稼働中のVU数 |
import exec from "k6/execution";

// VU番号(1始まり)からアカウントを1件選ぶ。
// アカウント数を超えても回るように剰余を取る
const account = accounts[(exec.vu.idInTest - 1) % accounts.length];
古い記事では __VU や __ITER というグローバル変数を使っている例もよく見かけます。今でも動きますが、分散実行しても番号が重複しない k6/execution の方が現在の書き方です。
3. シナリオの構成
3-1. ディレクトリの分け方
1ファイルに全部書くと、シナリオが2本目・3本目になった時点で管理しきれなくなります。サンプルは責務ごとにファイルを分けました。
k6-load-samples/
├── config/
│   ├── config.json          # 環境・負荷モデル・しきい値・ステップ設定
│   └── config.js            # ローダ(SharedArray で1回だけ読む / __ENV で上書き)
├── lib/
│   ├── options.js           # config.json → options.scenarios / thresholds
│   ├── checks.js            # 再利用する check 部品
│   ├── metrics.js           # ステップ別のカスタムメトリクス
│   ├── http.js              # リクエストパラメータ(name タグ付与)
│   ├── report.js            # handleSummary → HTML + JSON + テキストサマリ
│   ├── workflow.js          # 一連のフロー(両シナリオで共有)
│   └── util.js              # 乱数・安全なJSON取得・タイムスタンプ
├── steps/                   # 1ステップ = 1ファイル
│   ├── login.js
│   ├── uploadFile.js
│   ├── fetchList.js
│   ├── updateRecord.js
│   └── downloadReport.js
├── scenarios/
│   ├── load.js              # 負荷試験用
│   └── smoke.js             # 1VU×1回の疎通確認
├── data/
│   ├── accounts.json        # アカウント一覧
│   └── upload_sample.csv    # アップロードするファイル(500行・約34KB)
└── reports/                 # レポート出力先(gitignore)
分け方の基準は**「何を持たせないか」**で決めました。
| 層 | 持つもの | 持たないもの |
|---|---|---|
scenarios/ | どの負荷モデルで、どのフローを流すか | HTTPの詳細 |
lib/workflow.js | ステップの順序と分岐 | 個々のリクエスト |
steps/ | 1ステップのリクエストと検証 | 負荷モデル |
lib/ | 横断的な部品 | 業務の手順 |
config/ | 環境・負荷・しきい値 | ロジック |
この分け方だと、シナリオ本体はこれだけになります。何をするかだけを持ち、どれだけ負荷をかけるかは持ちません。
import CONFIG, { LOAD_OVERRIDES } from "../config/config.js";
import { buildOptions } from "../lib/options.js";
import { summaryFor } from "../lib/report.js";
import { runWorkflow } from "../lib/workflow.js";

export const options = buildOptions(CONFIG, LOAD_OVERRIDES);

export default function () {
  runWorkflow();
}

export function handleSummary(data) {
  return summaryFor(data, CONFIG, options.scenarios.load);
}なお、k6はv1.0からTypeScript(.ts)をトランスパイルなしで直接実行できます。ここまで層を分けてファイルを跨いで import する構成なら型があった方が変更に強くなるので、これから書き始めるならTypeScriptを選ぶ価値はあると思います。
3-2. ステップの区切り方
各ステップは group() で囲みます。囲んだまとまりの所要時間が group_duration というメトリクスとして自動で記録され、配下のリクエストやcheckにもグループ名のタグが付きます。
let token = null;

group("01_login", () => { token = login(CONFIG, account); });
if (!token) return;
group("02_upload", () => { uploadFile(CONFIG, token, uploadFileData); });
group("03_fetch",  () => { fetchList(CONFIG, token); });
group("04_update", () => { updateRecord(CONFIG, token); });
group("05_download", () => { downloadReport(CONFIG, token); });
if (!token) return; は必ず入れます。認証に失敗したまま後続のAPIを呼ぶと、401がすぐ返ってくる分、応答時間の平均が実際より良く見えてしまいます。
実物の lib/workflow.js は、各groupの中で steps.*.enabled(4章)を見てステップをスキップし、group間に thinkTime() を挟んでいます。ここでは構造が見えるよう省いています。
3-3. カスタムメトリクスの使いどころ
ステップごとの数字を自分で記録したいときのために、k6は4種類のメトリクスを用意しています。
| 種類 | 用途 | 例 |
|---|---|---|
Counter | 回数を数える | 失敗した回数 |
Gauge | 最後に記録した値を保持する | キューの長さ |
Rate | 真偽の割合を出す | 成功率 |
Trend | 数値の分布(平均・パーセンタイル)を出す | 応答時間 |
とはいえ、ステップごとの応答時間を見るだけなら自分で定義しなくてよいことも多いです。group() を切れば group_duration が取れますし、リクエストへ name タグを付ければ http_req_duration{name:"POST /api/ratings"} の形でしきい値も設定できます。自分で定義するのは、この2つで足りないと分かってからで間に合います。
サンプルが step_* というカスタムTrendを持っているのは、
- 一覧を2本叩いて1ステップ(③)
- 登録 → 更新 → 読み直しで1ステップ(④)
のように、複数リクエストの合計時間を1つの値として見たかったからです。1リクエストがそのまま1ステップなら、group と name タグで十分です。
4. 負荷のかけ方を設定ファイルに出す
負荷モデルをJSON側に置くと、VUを増やすのにJavaScriptを触らなくて済みます。サンプルでは負荷モデルだけでなく、しきい値やステップごとの設定も config/config.json にまとめています(thresholds と steps は項目が多いので一部だけ載せています)。
{
  "load": {
    "executor": "ramping-vus",
    "stages": [
      { "duration": "10s", "target": 5 },
      { "duration": "30s", "target": 5 },
      { "duration": "5s", "target": 0 }
    ],
    "gracefulStop": "10s",
    "thinkTimeSeconds": [0.5, 1.5]
  },
  "thresholds": {
    "http_req_failed": ["rate<0.01"],
    "checks": ["rate>0.99"],
    "step_login": ["p(95)<2000"]
  },
  "steps": {
    "upload":   { "enabled": true, "filename": "accounts_upload.csv" },
    "download": { "enabled": true, "bytes": 262144 }
  }
}
この load は、「10秒かけて5VUまで増やし、5VUのまま30秒維持して、5秒かけて0に戻す」という合計45秒の負荷を表しています。
gracefulStop— 終了時に実行中の反復が終わるのを待つ猶予thinkTimeSeconds— 各ステップのあとに挟む待ち時間の範囲(0.5〜1.5秒)
thresholds は合格条件、steps はどのステップを実行するかとその引数です。どちらもJavaScriptを書き換えずに変更でき、一時的な変更ならCLIから上書きすることもできます。
k6 run --env VUS=20 --env DURATION=3m scenarios/load.js # constant-vus に切り替わるstages と thresholds を外に出したいだけなら、k6が標準で --config を持っています。
k6 run --config options.json自前のローダを書く前に、まずこちらで済まないか確認した方がいいです。このサンプルが独自の config.json を使っているのは、接続先の切り替えやステップのON/OFFなど、k6の options では表現できない設定も同じファイルに置きたかったからです。
config.json から options を組み立てる処理(lib/options.js)でやっていることは、実質2つだけです。
thinkTimeSecondsのようなk6のオプションではないキーを除く- executorを切り替えたときに、そのexecutorで使えないキーを落とす
2つ目は必須です。例えば constant-vus に stages を渡すと、次のようなエラーで起動に失敗します。
json: unknown field "stages"一方、executor名そのものの妥当性はk6が検証してくれます。存在しないexecutorを指定すると unknown executor type '...' と落ちるので、この部分まで自前でバリデーションを書く必要はありませんでした。
5. テストデータの持ち方
アカウント一覧はinitコンテキストで1回だけ読み、SharedArray で共有します(2-2)。VUへの割り当ては exec.vu.idInTest を使います(2-4)。
const accounts = new SharedArray("accounts", () =>
  JSON.parse(open("../data/accounts.json")).accounts
);形式はJSONにしました。JSON.parse(open()) だけで読めるので、パーサを持たずに済みます。公式の Data parameterization ページもJSONを先に示していて、CSVを読むにはPapa Parseという外部ライブラリが必要と明記されています。
数万行規模のCSVを扱う必要があるなら、組み込みの k6/experimental/csv があります。csv.parse() は全行を SharedArray として読み込み、csv.Parser は1行ずつ読むので大きなファイルでもメモリに全体を載せずに済みます。v0.54で追加されたもので、まだ experimental 扱いです。
アップロードに使うファイルは、バイナリモードで開きます。第2引数の "b" を忘れると文字列として読まれてしまいます。
const uploadFileData = open("../data/upload_sample.csv", "b");If you want to open a binary file you need to pass in
"b"as the second argument.
— Data uploads
6. レスポンスの検証
6-1. check と thresholds の役割
check() は、レスポンスが期待どおりかを確かめて結果を記録する関数です。ただし、失敗してもテストは止まりませんし、失敗扱いにもなりません。
failed checks do not cause the test to abort or finish with a failed status.
If you need the whole test to fail based on the results of a check, you have to combine checks with thresholds.
— Checks
テストを失敗させるのは thresholds の役目です。k6には checks という組み込みのRateメトリクス(check全体の成功率)があるので、ここにしきい値を設定すれば「checkが失敗したらテストを落とす」が成立します。
thresholds: {
  checks: ["rate>0.99"]      // check の成功率が99%を下回ったら失敗
}
しきい値を満たさないと、k6の終了コードが0以外になります。
6-2. 何を検証するか
ステータスコードだけを見ていると、検証したつもりで何も確認できていないことがあります。更新系がその典型で、status === 200 を確認しても本当に値が反映されたかは分かりません。
そのためサンプルでは、登録 → 更新 → 読み直しまでを1ステップとして扱い、期待した値になっているかを確認しています。
// 更新
const patchRes = http.patch(url, JSON.stringify({ stars: 5 }), params);
check(patchRes, {
  ...statusIs(200),
  ...jsonFieldEquals("stars", 5)
});

// 読み直して、本当に反映されているか確認する
const verifyRes = http.get(url, params);
check(verifyRes, {
  ...statusIs(200),
  ...jsonFieldEquals("stars", 5),
  ...jsonFieldEquals("id", recordId)
});
この読み直しまで動くのは UPDATE_VERIFY_MODE=patch のときだけです。既定の接続先である公開デモは更新・削除を許可していないため、そちらでは登録までの検証にとどめています(1-2)。
ダウンロードも同じ考え方です。200が返っていても本文が空のことはあり得るので、受け取ったバイト数まで確認します。
check(res, {
  ...statusIs(200),
  ...bodySizeIs(262144)
});
アップロードは、サーバの応答形式によって確認方法が変わります。受信結果をJSONで返す実装なら、送信したサイズと一致するかを見ます。
check(res, {
  ...statusIs(200),
  ...jsonFieldEquals("filename", filename),
  ...jsonFieldEquals("receivedBytes", fileData.byteLength)
});
公開デモの /api/post のようにリクエスト本文をそのまま返す(echo)実装では、ファイル名とファイル本文の先頭が含まれることを見ます。この検証で一度つまずいた話は 8-6 に書きました。
どこまで検証するかは、「このステップが失敗したと判断できる条件は何か」から決めます。ステータスコードはその必要条件でしかありません。
6-3. check を部品にする
check() の第2引数には、「検証名 → 判定関数」のオブジェクトを渡します。このオブジェクトを1組だけ返す関数を作っておくと、呼び出した結果をスプレッド構文(...)で1つにまとめて check() に渡せます。6-2で使っていた ...statusIs(200) がその例です。
export function statusIs(expected) {
  return { [`status is ${expected}`]: (r) => r.status === expected };
}

export function jsonFieldEquals(path, expected) {
  return {
    [`${path} equals expected`]: (r) =>
      valueAt(safeJson(r), path) === expected
  };
}サンプルでは、statusIs、statusIsOneOf、fasterThan、jsonHasFields、jsonFieldEquals、jsonArrayAtLeast、bodySizeIs、bodyContains の8個を lib/checks.js に置きました。
r.status === expected のような判定ロジックは lib/checks.js 側へ移るので、各ステップに残るのは「ステータスが200であること」「stars が5であること」「レスポンスサイズが期待どおりであること」といった、確認したい内容だけになります。
7. 結果の見方
7-1. 標準のサマリと handleSummary
何も書かなければ、テスト終了時にk6が標準のサマリをコンソールへ出力します。v1.0からは --summary-mode(compact / full / disabled、既定は compact)で表示量を選べるので、まずはこれで足りるかを確認した方がいいです。
結果を自分で加工したい場合は handleSummary() を定義します。テスト終了時に集計済みのデータを受け取り、戻り値のオブジェクトを「ファイル名 → 中身」として書き出してくれます。
return {
‘stdout’: textSummary(data, { indent: ‘ ‘, enableColors: true }),
‘other/path/to/summary.json’: JSON.stringify(data),
};
— Custom summary
戻り値のキーがそのままファイル名になるので、外部ライブラリを使わなくてもHTMLレポートを組めます。サンプルの実装はこうなっていて、シナリオ側から呼ぶ summaryFor() が環境名や出力先を詰めて渡しています。
function buildSummaryOutputs(data, context) {
  const ts = timestamp();
  // summary と dir は data と context から組み立てたもの(抜粋のため省略)
  return {
    stdout: renderTextSummary(summary, context, ts, dir),
    [`${dir}/${ts}_report.html`]: renderHtml(summary, context, ts),
    [`${dir}/${ts}_summary.json`]: JSON.stringify(data, null, 2)
  };
}1つ注意点があって、handleSummary() を定義するとk6標準のコンソールサマリは出なくなります。サンプルでは stdout キーへ自前のテキストサマリを返すことで補っています。冒頭で紹介した出力がそれです。
7-2. 自作した理由と、その限界
HTMLレポートを自作した目的は1つで、しきい値の合否を表にすることでした。数字の羅列を渡して読み手に判断させるのではなく、レポートを開いた時点で「どの条件を満たしていて、どれを満たしていないか」が分かる状態にするためです。
もっとも、自作が最善というわけではありません。公式が想定している順番は、まず標準サマリ、次にファイルへのJSON出力や外部サービスへのストリーミングです。すでにGrafanaのような基盤があるなら、メトリクスをそのまま送ってしまう方が早いです。
k6 run -o experimental-prometheus-rw scenarios/load.js単発の結果を人に渡したいなら自作HTML、継続的に記録して推移を追いたいならメトリクス基盤、という使い分けになります。
時系列グラフだけが欲しいなら、コードを書かずに公式のweb dashboardで出せます。実行中もブラウザ(既定では localhost:5665)でリアルタイムに見られます。
K6_WEB_DASHBOARD=true K6_WEB_DASHBOARD_EXPORT=report.html k6 run scenarios/load.jsただし、グラフが入るのはテスト時間が集計周期の3倍を超えたときだけで、短い疎通確認ではグラフなしのHTMLになります。
もう1つの限界は対応するサマリ形式です。サンプルの lib/report.js はk6 v1.xの既定サマリだけを扱います。v1.5以降でオプトインできる --new-machine-readable-summary は別形式で、しきい値の合否が含まれないため、読み替えて中途半端に表示するよりレポートには「判定不能」と出して終了コードへ誘導しています。k6自体はどちらの形式でもしきい値を評価して終了コードに反映するので、CIの合否判定は影響を受けません。
7-3. CIに載せる
しきい値を満たさないとk6の終了コードが0以外になるので、ジョブはそのまま失敗します。レポートはアーティファクトとして残します。
- run: k6 run scenarios/smoke.js
- run: k6 run scenarios/load.js
- uses: actions/upload-artifact@v4
  if: always()
  with:
    name: k6-report
    path: reports/
8. 実装で気をつけたこと
サンプルを組みながら困ったところを挙げておきます。
8-1. check やメトリクスの名前を固定する
最初はこう書いていました。
check(res, {
  [`${apiName} ${res.status}`]: (r) => r.status === 200
});失敗時に何が返ったか分かるので便利に見えます。ただ、checkは名前ごとに集計されるため、import 200 と import 500 が別項目として数えられ、「このAPIの成功率」が1つの数字として読めなくなります。
IDを含むURLも同じ問題を起こします。k6は既定でリクエストURLをそのまま name タグにするので、/api/ratings/1、/api/ratings/2 … がそれぞれ別のメトリクスになってしまいます。
If your test has dynamic URL paths, you might not want this behavior, which could bring a large number of unique URLs into the metrics stream.
— URL grouping
name タグを明示してまとめます。
http.patch(`${base}/api/ratings/${id}`, body, {
  headers,
  tags: { name: "PATCH /api/ratings/:id" }   // メトリクス上はこの名前に集約される
});動的な値をすべて避ける必要はありません。テスト1回のなかで種類が増えなければ問題なく、設定ファイル由来の固定値(status is 200 など)なら影響しません。
8-2. 応答時間には成功したリクエストだけを入れる
前段のプロキシに即座に弾かれたリクエストは、0ms近くで返ってきます。それを応答時間のTrendに混ぜると、平均もパーセンタイルも実態より速くなります。3件だけ失敗した試験で平均3.52秒と出ましたが、成功分だけで計算すると3.66秒でした。実際より良い数字が出るため気づきにくいです。
export function recordStep(stepName, ok, durationMs, tags = {}) {
  const m = stepMetrics[stepName];   // 未定義ステップ名のガードは抜粋のため省略
  m.success.add(ok, tags);           // Rate:成功率
  if (ok) {
    m.duration.add(durationMs, tags);  // Trend:応答時間(成功分のみ)
  } else {
    m.failures.add(1, tags);           // Counter:失敗回数
  }
}
引き換えに、組み込みの http_req_duration は失敗したリクエストも含むため、この方式にすると数字がずれます。見ている対象が違うだけですが、レポートに両方載せるなら注記がいります。
8-3. サンプル0件のしきい値は通ってしまう
しきい値を置いても、対象メトリクスにデータが1件もなければ、黙って合格になります。ステップを無効化して実行すると、こうなりました。
  ステップ別 応答時間(成功したリクエストのみ)
    step              success        avg      p(95)        max
    step_login        100.00%   193.2 ms   204.3 ms   221.9 ms
    step_upload             -          -          -          -
    step_fetch        100.00%   385.0 ms   397.9 ms   398.8 ms
    step_update       100.00%   477.3 ms   526.0 ms   545.2 ms
    step_download           -          -          -          -

  しきい値
    ✓ step_upload              p(95)<3000
    ✓ step_download            p(95)<5000
Trendにデータが無いとサマリ上の p(95) は0になるため、条件を満たしてしまいます。すべて合格したことと、すべて検証できたことは別です。レポートに実行回数を併記しておくと、0件のまま合格している行を見分けられます。
なお、しきい値が参照するメトリクスそのものが存在しないと、k6は起動時にエラーで止まります。そのためサンプルの lib/metrics.js は、ステップを無効化していても全ステップ分のメトリクスを必ず定義しています。
似た理由で、checks: ["rate>0.99"] という書き方にも死角があります。これはテスト全体のcheckをまとめた成功率なので、1ステップだけ全滅していても、他のステップのcheckが十分あれば99%を超えてしまいます。ステップ単位で見たいなら、グループのタグを付けたサブメトリクスにしきい値を設定します。
thresholds: {
  "checks": ["rate>0.99"],                        // 全体
  "checks{group:::04_update}": ["rate>0.99"],     // 更新ステップだけ
  "group_duration{group:::04_update}": ["p(95)<3000"]
}
group:::04_update のコロンが3つに見えるのは、タグ名 group の区切りのコロンと、グループパスの先頭に付く :: が続いているためです。ネストしている場合は ::親::子 になります。
しかも、セレクタを書き間違えても k6 は何も言いません。存在しないグループ名を指定して実行してみたところ、エラーにも警告にもならず合格しました。
  しきい値
    ✓ checks{group:::99_typo_nonexistent} rate>0.99
対象が0件なので条件を満たしてしまう、前述とまったく同じ罠です。サブメトリクスにしきい値を設定したら、わざと落として ✗ が出ることを一度確認しておくのが確実です。
8-4. JSON.parse ではなく res.json() を使う
JSON.parse(res.body) を直接使うと、エラーページのHTMLが返ってきた瞬間に例外が出てVUが停止します。停止したVUの分だけ、意図した負荷も掛からなくなります。k6には res.json() があるので、そちらを例外処理でくるんで使います。
export function safeJson(res) {
  try {
    const parsed = res.json();
    return parsed === null || parsed === undefined ? {} : parsed;
  } catch (_e) {
    return {};   // JSONでなくても落ちない
  }
}
8-5. URLからのimportはバージョンを固定できるものだけにする
k6はHTTP(S)のURLからモジュールをimportできます。HTMLレポートのライブラリをこう書く例が広く出回っています。
import { htmlReport } from "https://raw.githubusercontent.com/.../main/dist/bundle.js";手軽ですが、これはテストを実行するたびに外部からコードを取得して実行しているということでもあります。公式もリスクを明記しています。
The imported modules are downloaded and executed at runtime, making it extremely important to make sure you trust the code before including it in a test script.
— Modules
とはいえ、一律でだめという話ではありません。Grafana公式の jslib.k6.io はメンテナンスされていて、URLにバージョン番号が入るので固定できます。
import { randomIntBetween } from "https://jslib.k6.io/k6-utils/1.4.0/index.js";判断の基準は、誰がメンテしているか分かるか、バージョンを固定できるか、実行時にネットワークが使えない環境で困らないか、の3点です。このサンプルは閉じた環境でも動かしたかったので、乱数やテキストサマリ程度は自前で実装し、外部依存をゼロにしています。
8-6. 時々失敗するcheckを放置しない
アップロードの検証で、送ったフォームフィールドの値がレスポンスに含まれることをcheckしていたら、5回に1回くらい失敗しました。
原因は2つ重なっていました。公開デモの /api/post はリクエスト本文をそのまま返す実装ですが、公開インスタンスでは前段で数KBに切り詰められます(34KB送信 → 応答3.7KBを実測)。そのうえ k6はmultipartのパートの並び順を保証しないため、ファイルパートが先に書かれた回だけ、後続のフォームフィールドが切り詰め位置より後ろに落ちていました。
// 並び順に依存する書き方
check(res, { ...bodyContains("form field", "k6-load-test-sample") });

// ファイルパートの先頭付近は必ず残るので、そこを見る
check(res, {
  ...bodyContains("filename", filename),
  ...bodyContains("file content", config.steps.upload.contentMarker)  // "record_id,account_id"
});断続的に失敗するcheckは、対象システムの問題ではなくテストの書き方に原因があることが多いです。しきい値を決める前に、同じ条件で数回流して結果が再現するかを確認しておきます。そうしないと、本番の試験で出た1件の失敗が本物かどうか判断できなくなります。
8-7. 大きなレスポンスの扱い
CSVや帳票のダウンロードを大量に実行すると、レスポンス本文がVUの数だけメモリに載ります。
discardResponseBodies — Specify if response bodies should be discarded by changing the default value of responseType to
nonefor all HTTP requests.(既定false)
— Options reference
破棄してよいのは中身を見ないリクエストだけです。サンプルのダウンロードはバイト数を確認するため responseType: "binary" で受け取っています。既定では破棄しておき、検証が必要なリクエストだけ受け取る形が現実的です。
9. まとめ
負荷の大きさはVU数と1 iterationの所要時間で決まります。VU数を増やしてもスループットが比例して上がるとは限らないので、流量を固定したいなら到着率を指定するexecutorを選びます。
実行条件は options に集約されますが、設定ファイル・環境変数・CLIフラグからも上書きできます。options 相当だけなら --config で足り、それ以外の設定も一緒に置きたくなったときに自前のJSONを検討します。
ステップの計測は group と name タグから始め、複数リクエストの合計を1つの値として見たいときだけカスタムメトリクスを足します。検証はステータスコードで止めず、更新は読み直して確認し、ダウンロードはバイト数まで見ます。
メトリクスやcheckの名前にリクエストごとに変わる値を入れないこと、失敗したリクエストの所要時間を平均に混ぜないことは、あとから直すと過去の結果と比較できなくなるので最初に決めておきます。
サンプルは k6 run scenarios/smoke.js だけで動きます。VU数やしきい値を書き換えて結果がどう変わるかを見ると、ここまでの内容をそのまま手元で確かめられます。

コメント